
지난 2주만 봐도 굵직한 소식이 쏟아졌습니다.
- OpenAI: 먼저 말을 거는 24시간 에이전트 dots와 GPT-6.1 Sol
- 메타: AI 에이전트를 실제 하드웨어에 연결하는 Muse Gadgets
- Anthropic: Claude Haiku 5.5 출시, Sonnet 5.5 캐시 읽기 가격 절반 인하
- 이미지·영상: 원하는 부분만 고치는 FLUX 3 Image, 4K HDR에 립싱크까지 붙인 Kling 4.0
저도 이런 소식을 매일 요약해서 받아 보지만 따라가기가 벅찹니다. 그런데 오래 고생한 문제가 우연히 본 영상 하나나 새 모델로 풀린 적이 많아서, 놓치면 안 된다는 강박도 생깁니다. 저와 같은 고민이 있는 분들이 많아서인지 요즘 LLM Wiki, 루프 엔지니어링처럼 각자의 지식 시스템을 만드는 분들이 많아졌습니다.
안드레 카파시는 최근 X 에 올린 글에서, 반복적인 일은 LLM 이 대부분 맡게 되니 사람은 그 결과를 감독하고 이해하는(oversight and understanding) 데 점점 더 많은 시간을 쓰게 될 거라고 했습니다. 정보를 많이 모으는 것보다, 무엇을 내 것으로 이해하고 남길지 고르는 일이 더 중요해진다는 뜻입니다.
이 글을 읽으며 셜록 홈즈의 기억의 궁전(mind palace)이 떠올랐습니다. 홈즈는 머릿속 방마다 기억을 정리해 두고 필요할 때 꺼내 쓰는데, 원작 주홍색 연구에서는 머리를 작은 다락방에 비유하며 무엇을 들일지 스스로 골라야 한다고 말합니다.
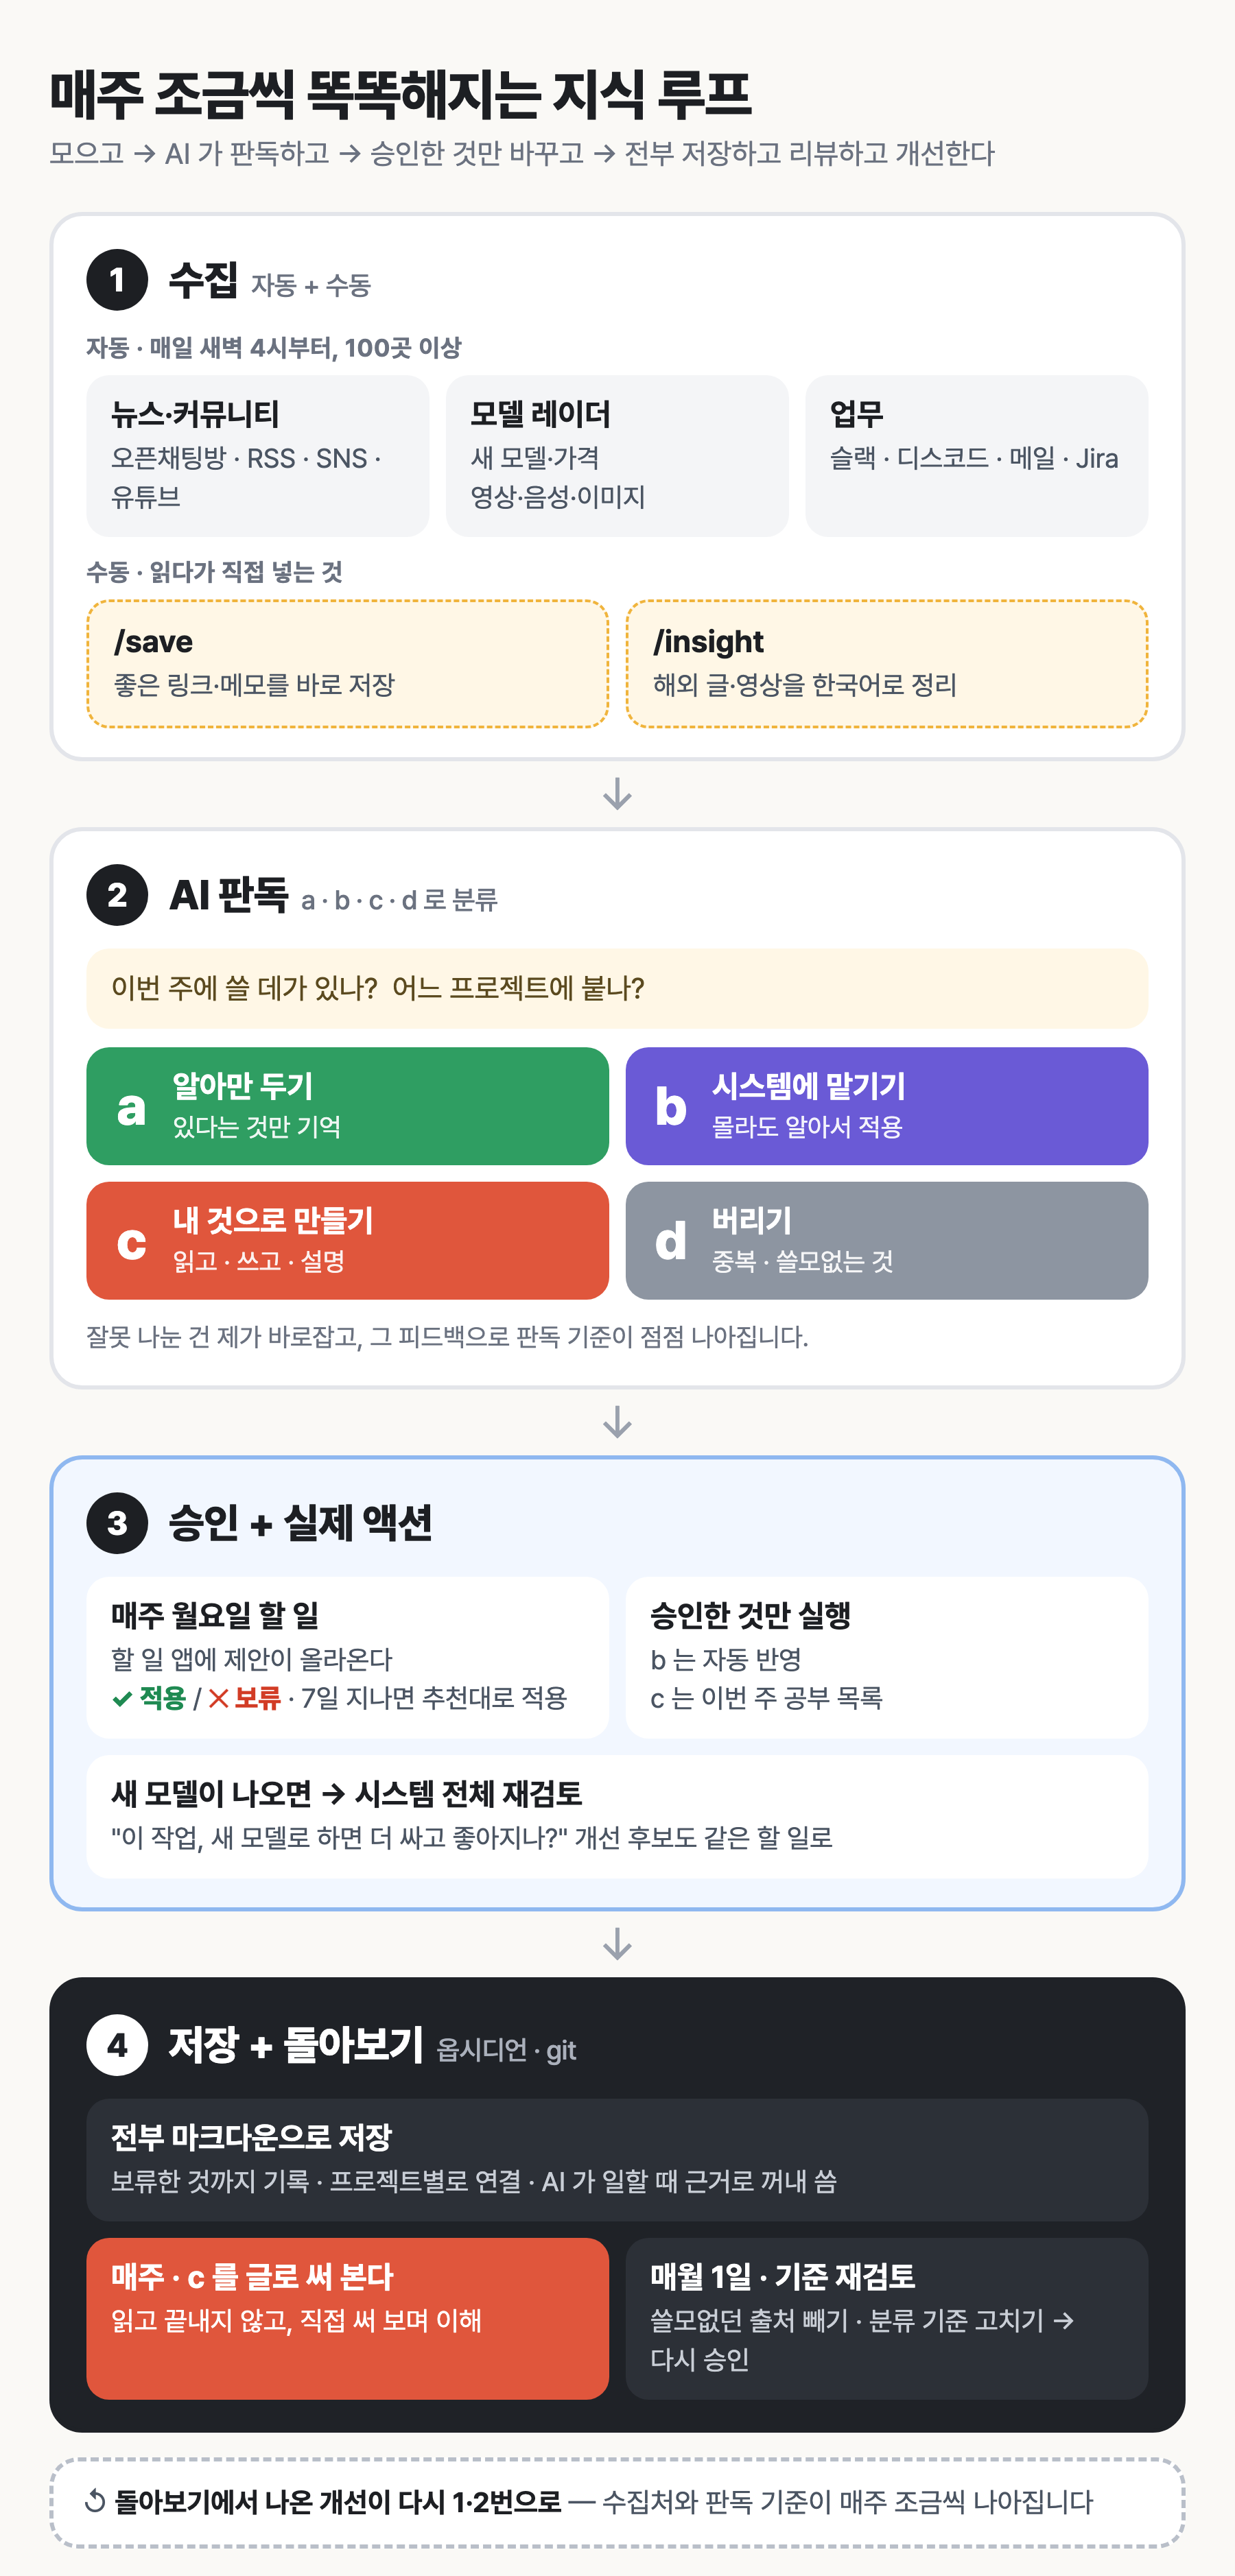
저도 쏟아지는 정보를 그렇게 골라 담고 필요할 때 꺼내 쓰고 싶어서, 1년 동안 고쳐 온 지식 시스템을 오늘 공유해 드리려고 합니다. 먼저 전체 구조도입니다(휴대폰에서는 이미지를 누르면 크게 볼 수 있습니다).
1. 수집 — 자동으로 모으고, 좋은 건 직접 넣는다
정보가 점점 더 많이 쏟아지는 만큼, 예전에는 시간을 들여 손으로 찾아보던 곳들에서 자동으로 정보가 수집되는 구조를 먼저 만들었습니다. 지금 제 컴퓨터에서는 새벽 4시부터 예약 작업이 돌면서 AI 오픈채팅방, 매체/블로그 RSS, SNS, GitHub 트렌딩, 해외 유튜브/팟캐스트, 1인/소규모 팀의 매출 사례까지 100곳이 넘는 곳에서 정보를 모읍니다. 새 모델과 가격 변화도 따로 지켜보는데, 400개가 넘는 모델을 모아 파는 OpenRouter와 영상/음성 모델이 많은 kie.ai의 목록을 매일 기록해 영상/음성/이미지 모델까지 놓치지 않게 했습니다. 업무 쪽으로는 슬랙/디스코드 대화, 메일, Jira 의 할 일까지 수집합니다.
자동 수집만으로는 부족해서, 읽다가 좋은 걸 발견하면 직접 저장하기도 합니다. 좋은 링크나 떠오른 메모는 save 스킬로 한 줄이면 전문과 요약이 저장되고, 해외 글이나 영상은 insight 스킬에 링크만 넣으면 한국어로 번역·요약해 저장하고 이 사이트의 글로벌 인사이트로 발행됩니다. 자동으로 쌓이는 것과 제가 직접 저장한 것이 같은 곳에 쌓여서 다음 단계로 넘어갑니다.
2. AI 판독 — a/b/c/d 로 나눈다
이 구조의 핵심은 정보를 나누는 기준입니다. 들어오는 모든 정보는 AI 가 제가 하고 있는 일(어디에나 적용할 수 있는 일, 또는 특정 프로젝트 A, B, C …)을 기준으로 "이번 주에 쓸 데가 있나, 어느 프로젝트에 붙나" 를 판독하고, 매주 월요일 아침에는 지난 7일치를 다음 네 가지로 나눕니다.
| 분류 | 무엇인가 | 실제 비율 |
|---|---|---|
| a 알아 둘 것 | 있다는 것만 알아 두면 나중에 "아 그거 있었지" 하고 꺼내 쓸 수 있는 것 | 9.6% (779개) |
| b 시스템에 맡길 것 | 도구 업데이트처럼 승인만 하면 시스템이 반영하는 것 | 69.8% (5,677개) |
| c 내 것으로 만들 것 | 시간을 들여 깊게 읽고, 써 보고, 설명해 볼 것. 특히 여러 프로젝트에서 반복해서 꺼내 쓰는 지식 | 1.9% (156개) |
| d 버릴 것 | 이미 저장해 둔 것과 같거나, 몇 달째 한 번도 꺼내 쓰지 않은 것 | 18.7% (1,521개) |
표의 실제 비율은 제 Vault(저장소)에 쌓인 지식 노트 8,133개 전체를 다시 나눠 본 결과입니다. c 는 대부분 두 개 이상 프로젝트에서 반복해서 쓰인 지식으로, 에이전트 협업·프롬프트·가격 전략 같은 것들이었습니다. 한 번이라도 다시 꺼내 본 노트는 전체의 11.5% 정도이고, 실제로 열어서 읽은 노트는 146개뿐이었습니다.
물론 AI 판독이 처음부터 정확하지는 않습니다. 매주 분류된 내용을 확인하고, 잘못 분류된 건 제가 피드백을 주고 분류 기준을 강화하면서 판독 기능 자체가 매주 나아지고 있습니다.
3. 승인 체계 — 승인한 것만 실제로 바뀐다
시스템이 스스로 발전한다는 말은 멋있지만, 내가 모르는 사이에 돌아가는 것이 계속 늘어나면 언젠가는 아무도 그 시스템을 이해하지 못하게 됩니다(카파시가 말한 감독과 이해가 불가능해지는 상태입니다). 그래서 a/b/c/d 분류, 개선 후보, 출처 추가/삭제까지 전부 제안으로만 만들고, 매주 월요일 아침 제가 만들어 개인적으로 쓰고 있는 할 일 앱에 할 일로 올라오게 해 놨습니다. 기본적으로 a/b/c/d 는 자동으로 분류되어 제안되고, 제가 따로 지시하면 분류가 바뀝니다. 1주일 동안 별도 지시가 없으면 추천된 분류 그대로 적용되고, 바로 적용하라고 하면 그 자리에서 적용됩니다.
이 승인 단계에서 제일 중요한 건, 새 기술·툴이 나왔을 때 이미 만들어 사용 중인 시스템도 개선할 수 있는지 다시 검토하는 일입니다. 예를 들어 Claude, Codex 등에 새 모델이 추가되거나 가격이 20% 이상 바뀌면 제 스킬·스크립트와 대조해 "이 작업은 이미지를 A 로 만드는데 B 가 새로 나왔고 가격이 절반이다, 시도해 볼까?" 같은 개선 후보를 만들고, 이것도 같은 방식으로 할 일로 올라와 제가 승인한 것만 실제로 바뀝니다.
4. 저장과 돌아보기 — 전부 남기고, 매주·매달 다시 본다
제 기억의 궁전은 옵시디언과 git 입니다. 한 곳에만 저장했다가 데이터를 통째로 날린 적이 있어서, 지금은 반드시 두 곳 이상에 동시에 저장해 자료가 손상되지 않게 하고 있습니다. 수집한 것, 판독 결과, 승인하거나 보류한 기록까지 전부 마크다운 파일로 저장되기 때문에 앱에 묶이지 않고 Claude 와 Codex 가 그대로 읽으며, 2번에서 붙인 프로젝트 정보 덕분에 일을 시작할 때 AI 가 관련 노트 중 활용할 만한 것이 있는지 먼저 확인하고 시작합니다.
매월 1일에는 전체 시스템 자체를 돌아봅니다. 카파시가 작년에 쓴 system prompt learning에서 말한 것처럼, 사람은 "다음에 이런 문제를 만나면 이렇게 하자" 는 메모를 고쳐 가며 배우는데, 제 시스템에서는 분류 기준·일 목록·출처 목록이 그 메모입니다. 출처별로 a/b/c/d 가 얼마나 나왔는지, 제가 승인한 비율은 어땠는지를 보고 "90일 동안 쓸 만한 게 없었던 출처는 빼자", "계속 고쳐 주는 분류는 기준을 바꾸자" 같은 변경을 시스템이 스스로 제안하고, 이것도 3번의 승인 절차를 거칩니다.
그리고 매주 c 를 이해하는 시간을 따로 가집니다. 예전에는 좋은 글을 읽고 생각해 보는 데서 끝났다면, 이제는 c 로 고른 것을 직접 글로 써 보면서 이해하려고 합니다. 지난 글에서 주 1회는 직접 글을 쓰겠다고 적은 것도 같은 이유이고, 지금 이 글이 그 결과물입니다. 실제로 이 글을 쓰면서 제 시스템을 남에게 설명하다 보니 구멍이 여러 곳 보였고, 쓰는 도중에 고쳤습니다. 글을 쓰는 일 자체가 시스템을 더 잘 이해하는 일이 되고, 동시에 시스템 자체를 개선하는 일이 되고 있습니다.
이해를 돕는 데는 규격 두 가지를 씁니다. 카파시가 같은 글에서 추천한 ASD-STE100은 항공기 정비 문서를 오해 없이 읽게 만든 영어 작성 규칙이고, 한국어에는 같은 취지의 국제 표준 ISO 24495-1(쉬운 글)을 씁니다. AI 에게 이 규칙으로 설명과 도식을 받은 뒤, 거꾸로 AI 가 저에게 문제를 먼저 내고 "이 개념을 모르는 팀원에게 3문장으로 설명해 보세요" 라고 묻는 스킬을 만들어 쓰고 있습니다. 예전에 공부할 때도 본문을 다 읽고 문제를 풀기보다, 문제를 먼저 풀면서 본문에서 답을 찾아가는 쪽이 더 빨랐던 적이 많아서 비슷한 방식으로 이해하려고 합니다. 다만 이 규격은 어디까지나 제가 이해하는 데 쓰는 도구에 가깝고, 진짜 이해는 이렇게 실제로 글을 써 보는 단계에서 확인하고 있습니다.
제가 쓰고 있는 이 구조에서 누구나 맥·리눅스에서 바로 설치해 쓸 수 있는 부분은 brain-attic으로 공개했습니다(설치 방법과 기능은 README 에 정리해 두었습니다). 써 보시고 불편한 점이나 필요한 기능을 알려 주시면 하나씩 고쳐 보겠습니다.
글을 마무리하며, 최근 『클린 코드』의 저자 로버트 C. 마틴(Uncle Bob)이 X 에 남긴 글을 옮겨 둡니다(번역은 Kim Wooyeong 님의 공유를 따랐습니다). 읽으면서 고개를 끄덕이게 됐습니다.
"사람들은 『클린 코드』의 저자가 더 이상 코드를 읽지 않는다는 사실에 놀라는 것 같습니다. 하지만 놀랄 일이 아닙니다. 제가 왜 『클린 코드』를 썼을까요? 코드를 깨끗하게 유지하는 목적은 무엇일까요? 코드가 진짜 일, 즉 '생각하는 것'을 방해하지 않게 하기 위해서입니다."
제가 이런 시스템을 만드는 것도 결국 같은 이유입니다. 모으고, 나누고, 반영하는 반복적인 일은 시스템에 맡기고, 그렇게 아낀 시간을 더 생각하는 데 쓰고 싶어서입니다.
결국 새 정보를 얼마나 많이 아느냐보다, 무엇을 알아만 두고, 무엇을 맡기고, 무엇을 끝까지 내 것으로 만들지 고르는 힘이 앞으로 일하는 방식을 가를 거라고 생각합니다. 여러분은 매주 쏟아지는 정보를 어떻게 소화하고 계신가요? 더 좋은 방법을 알고 계신 분들은 댓글로 꼭 알려주세요. 글이 마음에 드셨다면 주변 분께 공유해 주시거나 구독을 권해 주세요 :)
P.S. 1 — 이번 주에 본 표 하나
a16z 가 10월 5일 낸 소비자 AI 앱 Top 100 7번째 판에는, 인터넷 시대에 승자가 있던 분야마다 AI 전용 서비스가 자리를 잡았는지 정리한 표가 있습니다. 검색·제작·사진/영상·교육은 이미 AI 서비스가 들어섰지만, 스트리밍·쇼핑·SNS·여행·개인 금융·커리어·부동산·게임·데이팅에는 아직 Top 100 에 든 AI 전용 서비스가 하나도 없습니다(«None» 은 시장이 비었다는 뜻이 아니라 이 목록에 없다는 뜻입니다). 뭘 만들지 고민 중이라면 이 빈칸부터 보시면 좋겠습니다. 리포트 전체 요약은 글로벌 인사이트에 정리해 두었습니다.
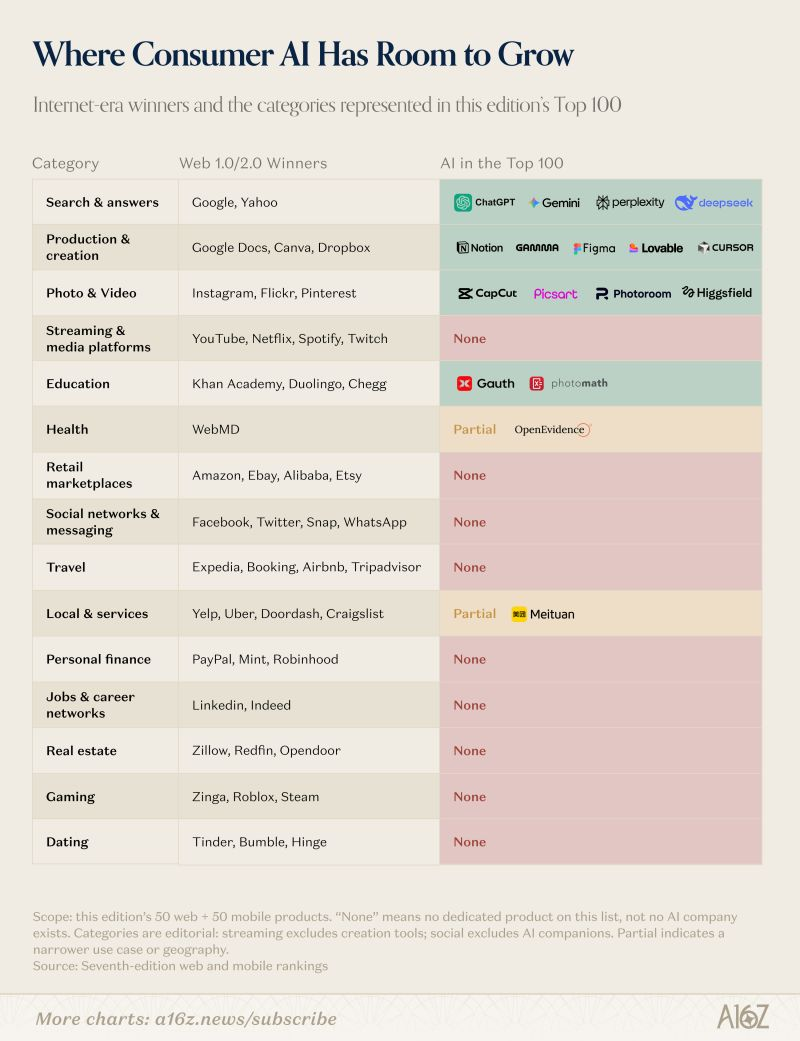
출처: a16z, The Top 100 Gen AI Consumer Apps — 7th Edition · 조여준 님의 LinkedIn 공유로 처음 봤습니다.
P.S. 2 13만 유튜버 일잘러 장피엠님이 B2B 기업 강의로 만들었던 비개발자를 위한 Claude Code 기초 강의를 인프런에서 한시적으로 무료 공개하셨습니다. 10월 15일까지 수강 신청만 해 두시면 이후 유료(15만 원)로 바뀐 뒤에도 계속 무료로 보실 수 있다고 하니, Claude Code 를 시작해 보고 싶었던 분들은 서둘러 신청해 두세요. 광고는 아니고, 평소 장피엠님 콘텐츠를 즐겨 보는 순수한 팬심으로 넣었습니다.
혹시 이렇게 구독자분들께 소개하고 싶은 강의나 서비스가 있으신 분들은 홍보 신청으로 남겨 주세요. 검토해 보고 연락드리겠습니다.
참고 자료
- 안드레 카파시, LLM 출력을 더 잘 이해하는 법(ASD-STE100, 도식, HTML, 설명 영상), 2026-10-02
- 안드레 카파시, LLM Knowledge Bases, 2026-04-02 / LLM Wiki idea file
- 안드레 카파시, system prompt learning, 2025-05-11
- karpathy/autoresearch · Reflexion: Language Agents with Verbal Reinforcement Learning · Addy Osmani, Loop Engineering
- ASD-STE100 Simplified Technical English · ISO 24495-1:2023 Plain language · 국제 쉬운 언어 연맹(IPLF)의 해설
- ISO 24495-1 을 추천한 링크드인 글
- 아서 코난 도일, 주홍색 연구(A Study in Scarlet)
- OpenAI dots · Meta Muse · Muse Gadgets · Claude Haiku 5.5 · FLUX 3 Image · Kling AI · OpenRouter · kie.ai
- 함께 참고한 지식 시스템: 복리 지식 시스템(Simpson Gyusup Sim) · LLM Wiki 구축 가이드(unclejobs) · Building a Second Brain · 제텔카스텐
- 로버트 C. 마틴, X @unclebobmartin, 2026-10-01 · 번역 Kim Wooyeong 님 LinkedIn
- a16z, The Top 100 Gen AI Consumer Apps — 7th Edition, 2026-10-05 · 조여준, LinkedIn 해설
- 공개 저장소: challengekim/brain-attic
댓글 0
첫 댓글을 남겨 주세요.